

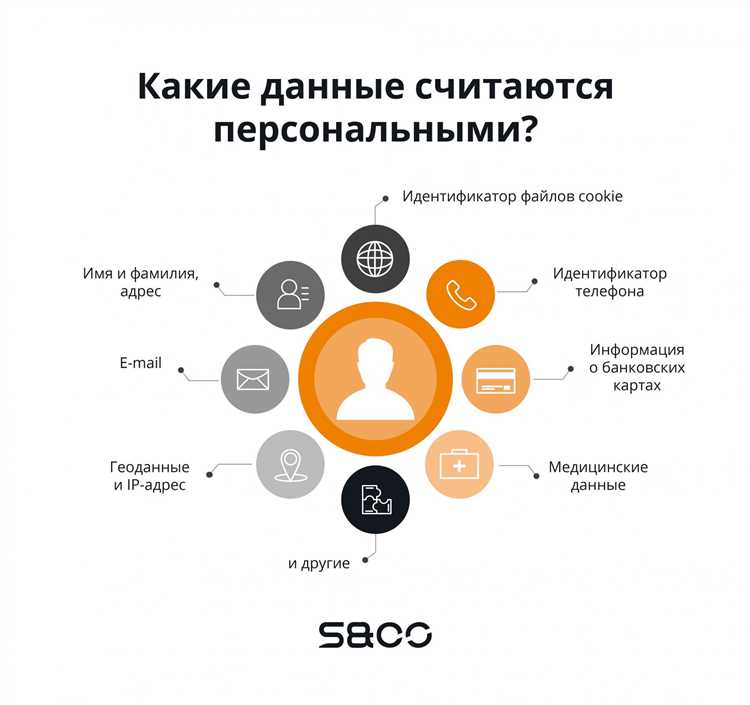
Извлечение персональных данных – это процесс выделения информации о человеке из различных источников: документов, форм, баз данных, логов и даже неструктурированных текстов. К таким данным относятся фамилия, имя, адрес, паспортные реквизиты, номера телефонов, e-mail, данные банковских карт. Их обработка используется для автоматизации проверки клиентов, настройки персонализированных сервисов и обеспечения юридических требований, например, в рамках GDPR или российского 152-ФЗ.
Технически извлечение происходит с помощью алгоритмов обработки естественного языка, регулярных выражений или специализированных систем анализа структурированных данных. Например, при загрузке скана паспорта система может автоматически распознать серию и номер документа, сверить их с базой и исключить ошибки ручного ввода. В больших компаниях применяются комплексные ETL-процессы (Extract, Transform, Load), где данные сначала выделяются, затем очищаются и интегрируются в хранилище.
Ключевая рекомендация при работе с извлечением персональных данных – минимизация набора собираемой информации. Хранить следует только те сведения, которые реально необходимы для бизнес-процессов. Важно внедрять механизмы шифрования и разграничения доступа: данные должны быть доступны лишь сотрудникам, имеющим прямую рабочую необходимость. Дополнительной практикой считается регулярный аудит и настройка логирования, что позволяет контролировать каждое обращение к персональной информации.
Какие методы применяются для автоматического извлечения персональных данных
Чаще всего применяется распознавание регулярных выражений, когда система выделяет номера паспортов, телефонов, e-mail и идентификаторы по строго заданным шаблонам. Этот метод удобен для структурированных данных, но ограничен в случае вариативных форматов.
Для анализа неструктурированного текста используется обработка естественного языка (NLP). Алгоритмы определяют имена, адреса и даты на основе лингвистических правил и контекста, что повышает точность извлечения при работе с документами и перепиской.
Методы машинного обучения позволяют выявлять персональные данные по статистическим закономерностям, обучаясь на размеченных наборах. Такой подход подходит для больших массивов текста, где невозможно заранее описать все варианты написания.
Гибридные системы объединяют шаблоны, NLP и машинное обучение. Это снижает риск пропуска информации и уменьшает количество ложных срабатываний, что особенно важно при обработке юридических и медицинских документов.
Для потоковых данных применяются алгоритмы реального времени, которые интегрируются в каналы передачи информации и сразу выявляют персональные элементы. Такой метод используется в банковских системах и службах безопасности.
Как различаются структурированные и неструктурированные источники данных
Структурированные данные представляют собой информацию, заранее организованную в формате, который легко анализировать с помощью алгоритмов. К таким источникам относятся базы данных, CRM-системы, электронные анкеты, где каждая запись фиксируется в определённых полях: имя, адрес, дата рождения, номер телефона. Эти данные удобно фильтровать, сортировать и использовать для автоматического извлечения персональных сведений.
Неструктурированные источники включают тексты электронных писем, документы, изображения, аудио- и видеозаписи, публикации в социальных сетях. В таких случаях данные не имеют единого формата: номер телефона может встречаться в произвольном месте письма, а имя человека – в подписи под фото. Для анализа применяются инструменты обработки естественного языка, распознавания изображений и аудиозаписей, что требует значительно больше вычислительных ресурсов.
При работе с персональными данными важно учитывать различия этих источников. Для структурированных данных эффективнее использовать SQL-запросы и встроенные механизмы фильтрации. Для неструктурированных – алгоритмы машинного обучения и регулярные выражения, позволяющие выделять ключевые сущности. Комбинация методов повышает полноту и точность извлечения.
Какие технологии используются для распознавания имен, адресов и контактов
Извлечение персональных данных требует инструментов, которые способны выделять сущности из неструктурированного текста. Для этого применяются технологии обработки естественного языка и специализированные алгоритмы анализа.
- NER (Named Entity Recognition) – модели выделяют имена людей, организации и географические объекты. Используются библиотеки spaCy, Stanza, Natasha, которые обучены на корпусах русского языка.
- Регулярные выражения – применяются для поиска телефонных номеров, email-адресов и индексов. Их эффективность высока при стандартизированных форматах записи.
- Словарные методы – базы распространённых фамилий, географических названий и аббревиатур помогают повысить точность в случаях, когда статистическая модель допускает ошибки.
- Модели на основе трансформеров – BERT, RuBERT, XLM-R позволяют учитывать контекст, что особенно важно для различения совпадающих по форме слов (например, «Мир» как фамилия и «мир» как существительное).
- Геокодинг – сервисы типа Яндекс Геокодера или Google Maps API уточняют найденные адреса, нормализуя их до официального почтового формата.
Практическая рекомендация: комбинировать статистические модели с регулярными выражениями и словарями, а результаты нормализовать через внешние API. Такой подход снижает количество ложных срабатываний и делает извлечение пригодным для последующей автоматизированной обработки.
Как алгоритмы машинного обучения помогают находить скрытые персональные сведения
Машинное обучение используется для автоматического выявления данных, которые напрямую не указаны в тексте, но могут быть реконструированы из косвенных признаков. Такой подход применяют в анализе больших массивов текстов, аудиозаписей и изображений, где скрытая информация часто маскируется под безобидные фрагменты.
Основные методы:
- Классификация текста: алгоритмы определяют, относится ли фрагмент к категории персональных данных, даже если он не содержит явных указателей. Например, описание маршрута поездок может указывать на место жительства.
- Обработка естественного языка (NLP): модели распознают сущности (имена, адреса, номера документов) и восстанавливают недостающие элементы через контекст. При наличии лишь названия улицы система способна предсказать город.
- Анализ поведенческих паттернов: машинное обучение выявляет уникальные комбинации действий пользователя (время входа, последовательность кликов), по которым можно идентифицировать личность без прямых данных.
- Обработка изображений и видео: нейросети сопоставляют детали на фото с открытыми источниками, что позволяет находить скрытые связи между человеком и его окружением.
Чтобы минимизировать риск утечек:
- Регулярно тестировать модели на избыточное извлечение сведений, которое выходит за рамки задачи.
- Применять методы дифференциальной приватности, снижающие вероятность восстановления личности из обезличенных данных.
- Использовать интерпретируемые алгоритмы, чтобы отслеживать, на основании каких признаков происходит выделение скрытой информации.
- Ограничивать доступ к исходным наборам данных и применять строгие политики анонимизации перед обучением моделей.
Таким образом, машинное обучение не только усиливает возможности по обнаружению персональных данных, но и требует строгого контроля, чтобы предотвратить их нежелательное раскрытие.
Какие ошибки чаще всего возникают при извлечении персональных данных

Часто данные извлекаются без четкого понимания структуры источника. В результате алгоритмы путают имена с названиями организаций или телефоны с идентификаторами аккаунтов. Это приводит к искажению базы и снижает ее ценность.
Неправильная настройка инструментов распознавания текста приводит к пропуску символов, особенно в сканированных документах. Ошибки OCR делают адреса или паспортные номера недостоверными, а автоматическая обработка таких данных повышает риск некорректных решений.
Отсутствие проверки актуальности информации – еще одна распространенная проблема. Даже корректно извлеченные данные теряют ценность, если они устарели, например, адрес проживания или контактные телефоны.
Игнорирование контекста приводит к неверной классификации. Один и тот же набор символов может быть номером счета, кодом клиента или частью случайной строки, если алгоритм не учитывает соседние данные.
Хранение извлеченных данных без маскирования повышает риск утечек. Ошибкой считается не только их передача третьим лицам, но и размещение на внутренних серверах без ограничения доступа.
Снижение ошибок достигается использованием гибридных методов: сочетания машинного обучения с ручной верификацией, регулярной актуализацией справочников и строгим контролем прав доступа.
Как проверяется точность и достоверность выделенной информации
Для проверки точности извлеченных персональных данных используют методы сопоставления с официальными источниками: государственными реестрами, банковскими и страховыми базами, системами идентификации. Достоверность оценивается через контрольные значения, например, проверку корректности ИНН, паспортных данных или адресов электронной почты по стандартным алгоритмам верификации.
Автоматизированные системы применяют алгоритмы двойного контроля: данные сначала извлекаются с использованием правил и моделей машинного обучения, затем проверяются через кросс-ссылки с внешними источниками. Ошибки классифицируются по типу: пропущенные значения, некорректные форматы и несоответствие контексту.
Для повышения точности рекомендуют внедрять следующие подходы:
- Многоуровневую проверку идентификаторов через независимые источники.
- Использование регулярных выражений и контрольных сумм для обнаружения форматных ошибок.
- Анализ семантического контекста, чтобы исключить неверное связывание данных между разными лицами.
- Периодическое обновление справочных баз, чтобы отражать актуальные изменения в государственных и коммерческих реестрах.
Важным этапом является аудит алгоритмов извлечения. Для этого применяются выборочные проверки: выбирается часть данных и проверяется вручную по первоисточникам. Показатели точности оцениваются через метрики полноты, корректности и актуальности информации.
Современные системы используют логирование всех этапов обработки, что позволяет отслеживать источник ошибки и корректировать правила извлечения. При массовой обработке данных применяются автоматические скрипты, которые сигнализируют о расхождениях между выделенной информацией и контрольными значениями, что снижает риск попадания неверных данных в корпоративные или государственные базы.
Какие правила безопасности нужно учитывать при работе с извлечёнными данными
Необходимо использовать шифрование данных в покое и при передаче. AES-256 рекомендуется для локальных баз данных, TLS 1.3 – для передачи через сети. Любые резервные копии также должны быть зашифрованы и храниться отдельно от основной базы.
Все действия с данными должны фиксироваться в журналах аудита. Логи должны содержать информацию о времени доступа, идентификаторе пользователя и типе операции. Это обеспечивает отслеживаемость и возможность выявления подозрительных действий.
Применяйте анонимизацию и псевдонимизацию при обработке данных, если точная идентификация личности не требуется. Например, замена ФИО и контактов на уникальные идентификаторы снижает риск утечки.
Обновление программного обеспечения и библиотек, используемых для работы с данными, должно быть регулярным. Устаревшие версии создают уязвимости для атак и не соответствуют стандартам защиты информации.
Не храните данные дольше необходимого срока. Установите автоматические механизмы удаления или архивирования информации после завершения целей обработки.
Передача персональных данных третьим лицам должна осуществляться только по законным основаниям и через защищённые каналы, с подписанием соглашений о конфиденциальности и ответственности за утечку.
Регулярно проводите тесты на проникновение и аудит безопасности всех систем, где хранятся извлечённые данные. Это помогает выявить слабые места и минимизировать риски.
Обучение сотрудников базовым принципам безопасности и обработке данных с соблюдением требований GDPR, ФЗ-152 и локальных стандартов является обязательным. Контроль знаний должен быть документирован.
Вопрос-ответ:
Что понимается под извлечением персональных данных?
Извлечение персональных данных — это процесс получения информации о конкретных людях из различных источников. Сюда могут входить адреса, номера телефонов, электронная почта, информация о привычках и предпочтениях. Такие данные собираются для анализа, создания профилей или контроля за использованием сервисов, но без согласия владельца это может нарушать права человека.
Какие методы чаще всего используют для получения персональной информации?
Существуют разные способы извлечения данных. Некоторые методы предполагают прямое взаимодействие с пользователем через формы на сайтах или приложения, где человек сам предоставляет сведения. Другие используют автоматизированные системы, которые анализируют публичные базы данных, социальные сети или файлы cookie. Также применяются методы анализа поведения на сайтах и приложениях, позволяющие строить полные профили пользователей.
Можно ли распознать, что мои данные извлекаются?
Распознать извлечение не всегда просто. Иногда пользователи замечают это по появлению необычной рекламы, предложений или писем, соответствующих их интересам. Другие признаки — неожиданные запросы на подтверждение информации или подозрительные активности в учетных записях. Однако часть методов работает скрытно, и единственный способ защитить себя — внимательно следить за своими настройками конфиденциальности и использовать инструменты ограничения отслеживания.
Какие риски связаны с извлечением персональных данных?
Риски включают возможность мошенничества, утечки конфиденциальной информации, нежелательной рекламы или слежки. Если данные попадают в руки злоумышленников, это может привести к финансовым потерям, компрометации аккаунтов или использованию информации против человека. Поэтому важно контролировать, какие данные вы предоставляете онлайн, и проверять политику конфиденциальности сервисов.
Какие меры защиты помогают ограничить извлечение данных?
Существует несколько способов уменьшить сбор информации о себе. Важно использовать надежные пароли и двухфакторную аутентификацию, ограничивать доступ приложений к личной информации, регулярно проверять настройки конфиденциальности в социальных сетях. Также полезно блокировать файлы cookie от сторонних сайтов и использовать программы, которые предупреждают отслеживание. Эти меры не делают пользователя полностью невидимым, но значительно снижают риски нежелательного сбора данных.
Что именно понимается под извлечением персональных данных?
Извлечение персональных данных — это процесс получения информации о конкретном человеке из различных источников, таких как базы данных, интернет-сервисы или публичные документы. В ходе извлечения могут использоваться автоматические программы или ручной поиск, чтобы собрать адреса электронной почты, номера телефонов, сведения о местоположении, предпочтениях и других характеристиках пользователя. Цель такого процесса может быть разной: исследование, аналитика, маркетинговые задачи или безопасность, однако важно учитывать законность таких действий и требования к защите личной информации.
Какие методы применяются для извлечения персональных данных и чем они различаются?
Существуют различные подходы к извлечению информации о людях. Один из методов — это сбор данных из открытых источников, например, из социальных сетей, форумов, сайтов с отзывами. Другой подход — использование программного обеспечения, которое автоматически сканирует страницы, распознаёт контактные данные и структурирует их в базе. Существуют также технические методы, включающие анализ сетевого трафика или работу с регистрационными и публичными базами. Разница между ними заключается в том, что одни методы требуют прямого взаимодействия с источником и более трудоёмки, тогда как другие позволяют получать большие объёмы данных быстро, но могут не учитывать контекст и точность информации.


